Centocinquantasei aziende americane, undici settori diversi, quattro milioni di candidature. E una sola piattaforma di valutazione comportamentale a monte di tutto — gli stessi giochi, gli stessi punteggi, applicati da un'azienda che seleziona ingegneri a una che seleziona magazzinieri. È il disegno dello studio che un gruppo di ricercatori Stanford ha pubblicato a giugno 2026 con il titolo Algorithmic Monocultures in Hiring (ne avevano circolato le prime cifre già a fine maggio), ed è un disegno insolito: quasi mai capita di poter guardare dentro lo stesso strumento usato da datori di lavoro che non hanno alcun rapporto tra loro.
Il risultato, in sintesi: i candidati Neri e Asiatici incontrano tassi di rifiuto sistematicamente più alti quando lo screening iniziale passa da questo tipo di piattaforma, e la cosa peggiora — non migliora — quando più aziende si affidano allo stesso algoritmo.
La regola dei quattro quinti
Per stabilire che cosa conta come discriminazione, i ricercatori non hanno usato un criterio inventato per l'occasione. Hanno applicato la four-fifths rule, la regola dei quattro quinti che l'Equal Employment Opportunity Commission statunitense usa da decenni per individuare l'adverse impact: se il tasso di selezione di un gruppo scende sotto l'80% del tasso del gruppo più favorito, quello è un segnale che la legge prende sul serio, a prescindere dalle intenzioni di chi ha costruito lo strumento.
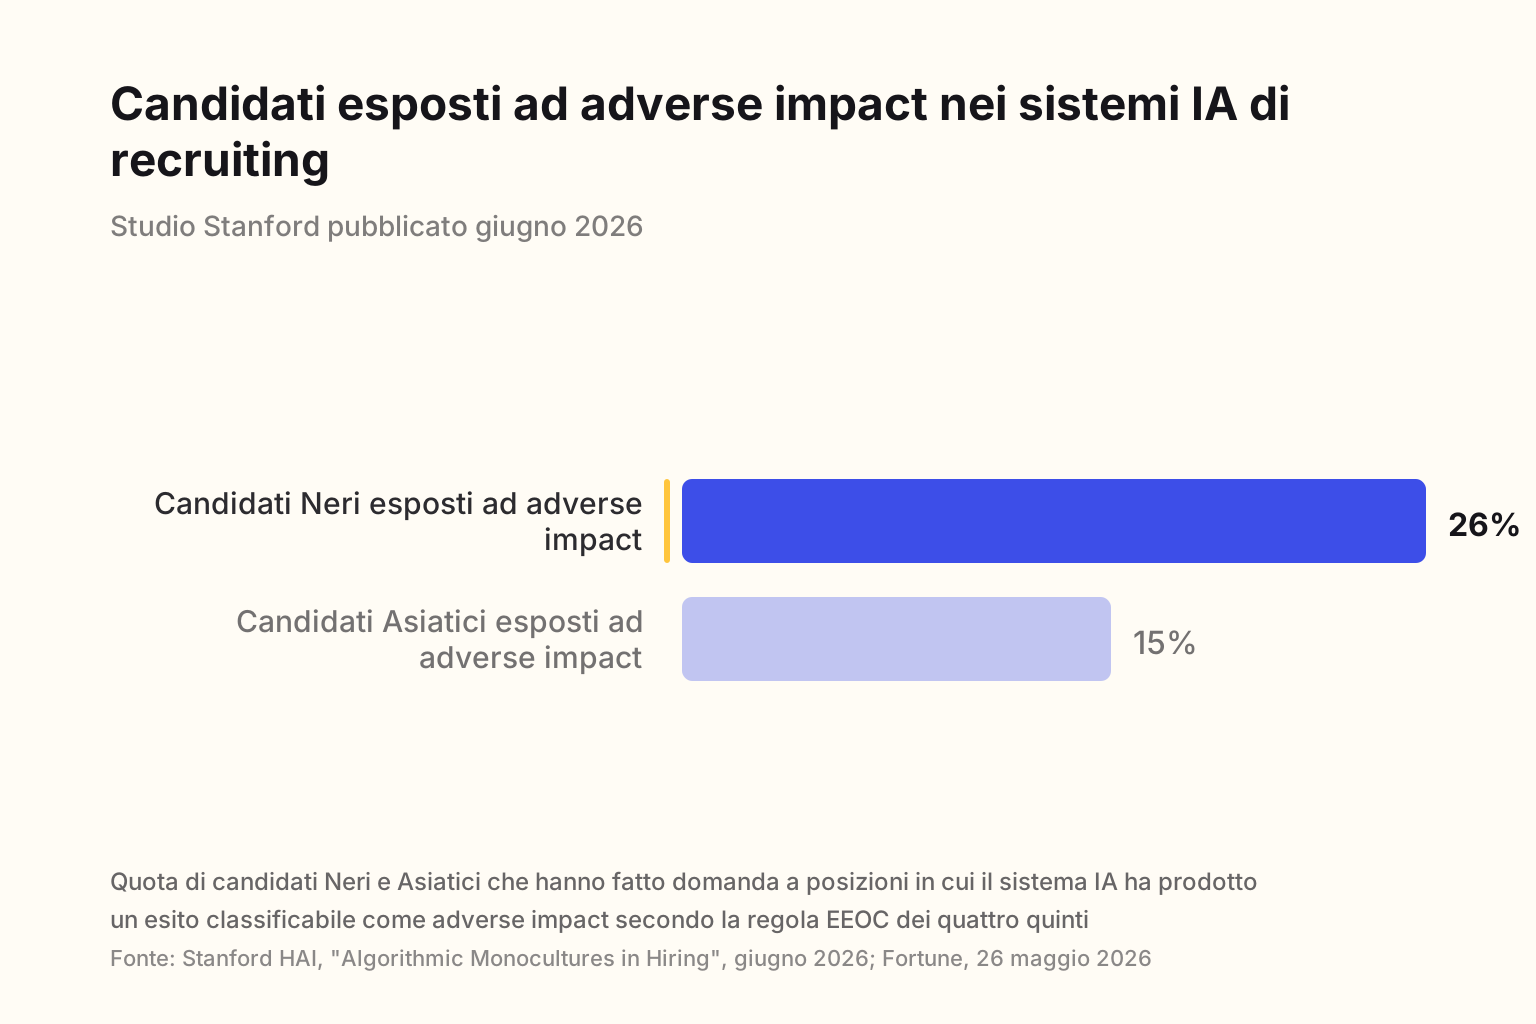
Applicando questa soglia posizione per posizione — 1.746 ruoli analizzati separatamente, non aggregati in un unico calderone che avrebbe nascosto le differenze tra un ruolo e l'altro — lo studio trova che il 26% dei candidati Neri e il 15% dei candidati Asiatici hanno fatto domanda a posizioni in cui il sistema produceva proprio quel tipo di esito. Tradotto in ruoli invece che in candidati: l'adverse impact contro i candidati Neri compare in un ruolo su dieci, contro gli Asiatici in uno su venti. Non sono percentuali che emergono da un singolo cliente malfunzionante: emergono da un campione di 3,4 milioni di persone distribuite su un'intera base clienti.
C'è una cifra, dentro lo studio, che rende la cosa concreta per chi deve giustificarla a un consiglio di amministrazione: se il sistema avesse raccomandato i candidati Neri allo stesso tasso del gruppo più favorito, circa 40.000 candidature in più sarebbero avanzate alla fase successiva. Non persone assunte — candidature che avrebbero semplicemente superato il primo filtro, come hanno fatto le candidature equivalenti di altri gruppi.
Quando l'errore smette di essere rumore e diventa sistema
Qui però c'è un meccanismo in più, ed è quello che dà il titolo allo studio: la monocoltura algoritmica. Il concetto è semplice da spiegare con un confronto. Se cento aziende usassero cento selezionatori umani diversi, ciascuno con i propri pregiudizi, un candidato scartato dal selezionatore della prima azienda potrebbe benissimo piacere al selezionatore della seconda: gli errori, essendo idiosincratici, tendono in parte a scompensarsi su scala di popolazione. È un punto che la letteratura sul rumore nei giudizi professionali ha reso familiare: valutatori diversi sullo stesso caso producono esiti diversi, e quella variabilità, per quanto fastidiosa dentro una singola organizzazione, non colpisce sempre la stessa persona ovunque si presenti.
Quando le 156 aziende dello studio condividono gli stessi 42 modelli di scoring, quella scompensazione sparisce. Non perché il bias diventi più forte in assoluto, ma perché smette di essere rumore distribuito e diventa un unico segnale correlato, ripetuto identico da un employer all'altro. I ricercatori hanno trovato prove dirette di questo: alcuni candidati venivano respinti ripetutamente da aziende diverse, un'impronta coerente con l'uso dello stesso algoritmo a monte di selezioni formalmente indipendenti. Quello che un candidato vive come dieci colloqui con dieci aziende diverse è, nel momento del primo filtro, la stessa valutazione ripetuta dieci volte.
Il rifiuto che segue il candidato
Questo è il punto che distingue il bias algoritmico dal bias umano in modo che vale la pena di non liquidare con un'alzata di spalle: un selezionatore prevenuto chiude una porta; un algoritmo condiviso le chiude tutte insieme, nello stesso momento, con lo stesso criterio, senza che nessuna delle aziende coinvolte lo sappia — perché ciascuna vede solo i propri risultati, mai il pattern che attraversa il mercato. È esattamente il meccanismo che rende l'automazione difficile da contestare: il criterio di selezione è stato deciso una volta, da un fornitore, e da lì in poi si applica senza che nessuno dei clienti lo riesamini caso per caso.
Vale la pena notare un limite metodologico che lo studio stesso dichiara e che la stampa, nel riprenderlo, tende a smussare: i dati vengono da un'unica piattaforma, quella che offre valutazioni comportamentali tramite giochi (il settore le chiama games-based assessment). Non è detto che lo stesso pattern di monocoltura valga per ogni fornitore o per ogni genere di strumento algoritmico usato in selezione. È una differenza che conta, perché una ricerca pubblicata poco dopo e che ha testato quattordici modelli linguistici generativi ha trovato l'opposto: a partire dai modelli rilasciati dal 2024 in avanti, nessuna preferenza razziale statisticamente significativa, in alcuni casi persino un favore verso i candidati Neri. Sono due famiglie di strumenti diverse — un modello di scoring comportamentale addestrato su dati storici di selezione non è la stessa cosa di un modello linguistico che genera un giudizio da un prompt — e mettere le due cose nello stesso paragrafo come se dicessero la stessa cosa sull'"IA nelle assunzioni" sarebbe proprio l'errore di generalizzazione che l'approccio attuariale ha sempre provato a disciplinare: il risultato vale per lo strumento testato, non per la categoria.
Quello che lo studio non misura
C'è un'altra cosa che lo studio non dice, ed è altrettanto importante di quello che dice: non sappiamo, da questi dati, se la piattaforma predica davvero la prestazione lavorativa. Lo studio misura la disparità degli esiti, non la validità predittiva dello strumento — cioè quanto il punteggio del gioco comportamentale si correli con quello che succede dopo l'assunzione. Sono due domande distinte e vanno tenute separate: uno strumento potrebbe produrre disparità etniche ed essere comunque predittivo del rendimento, oppure essere discriminatorio e al tempo stesso privo di qualunque capacità predittiva — il peggiore dei due mondi, perché scarta persone sulla base di qualcosa che non misura nulla di rilevante. Nessuna delle fonti qui raccolte risponde a questa seconda domanda per questa specifica piattaforma, e quindi non la si può dare per risposta.
Un audit che fa scuola
Qui va detto apertamente, senza le cautele che di solito accompagnano un giudizio positivo in questa rubrica: questo è uno dei casi in cui la ricerca ha fatto quello che quasi nessun fornitore fa da solo. Un criterio esterno e indipendente — la regola federale sull'adverse impact, non una metrica inventata dal venditore della piattaforma. Un'analisi condotta posizione per posizione, lo stesso livello di granularità che userebbe un tribunale, invece di un numero aggregato comodo da citare in una slide. E una dichiarazione esplicita dei limiti: il campione è un'unica piattaforma, il meccanismo di monocoltura è documentato ma non ancora quantificato in termini di quanto aggrava il bias rispetto a un mercato di algoritmi diversificati. Pubblicare questo genere di numero, con questo genere di cautela, è già più di quanto facciano la maggior parte dei fornitori di strumenti di selezione — che preferiscono parlare di "oggettività" senza mai specificare oggettività rispetto a quale criterio, misurata con quale errore.
Per chi sceglie uno strumento di screening algoritmico lunedì mattina, la domanda utile non è se l'IA sia più o meno prevenuta di un selezionatore umano — è se sa quanti altri suoi concorrenti, nello stesso settore, stanno usando lo stesso fornitore, e se qualcuno in azienda ha mai chiesto che prove esistono che quel punteggio predica qualcosa oltre al punteggio stesso.
8 fonti, verificate prima di pubblicare
Apri l'elenco
- https://hai.stanford.edu/news/ai-hiring-tools-can-yield-racial-bias-and-systemic-rejection
- https://news.stanford.edu/stories/2026/06/ai-hiring-tools-racial-bias-research
- https://www.testgorilla.com/blog/ai-hiring-bias/
- https://fortune.com/2026/05/26/ai-hiring-algorithm-racial-disparities-pymetrics-stanford-study/
- https://www.brightmine.com/us/resources/hr-compliance/discrimination/study-finds-extensive-racial-bias-by-ai-hiring-tools/
- https://www.knowyourrightscamp.org/post/ai-hiring-tools-can-yield-racial-bias-and-systemic-rejection
- https://hrdailyadvisor.hci.org/2026/07/13/new-stanford-study-reveals-bias-in-ai-hiring-tools-raises-stakes-for-employers/
- https://www.unite.ai/the-apparent-180-degree-reversal-in-ai-hiring-bias-since-2024/
Ogni affermazione empirica di questo pezzo è ancorata a una fonte verificata durante la scrittura. Se ne trovi una che non regge, segnalacela: la correzione è parte del metodo.