Molte slide di selezione che circolano ancora nelle aziende italiane citano un numero del 1998: 0,51, la validità predittiva stimata da Schmidt e Hunter per i test di abilità cognitiva generale rispetto alla prestazione lavorativa. È probabilmente il coefficiente più citato nella storia della psicologia del lavoro applicata alle assunzioni. Nel novembre 2022, sul Journal of Applied Psychology, quel numero è stato rivisto — e con esso l'intera gerarchia dei metodi di selezione si è ridisegnata. Al primo posto, oggi, non ci sono più i test cognitivi. Ci sono i colloqui strutturati, con una validità predittiva di 0,42.
Il numero più citato nelle slide di selezione andava rivisto
Lo studio è Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range, firmato da Paul Sackett, Charlene Zhang, Christopher Berry e Filip Lievens, pubblicato sul Journal of Applied Psychology (vol. 107, n. 11, pp. 2040-2068). Il titolo dice già tutto quello che serve sapere prima di guardare i numeri: non è una nuova raccolta di dati, è una revisione del modo in cui i dati vecchi venivano corretti.
Le meta-analisi degli anni Novanta correggevano sistematicamente i coefficienti grezzi per un problema reale, la restrizione di range: quando si misura la validità di un test solo sulle persone effettivamente assunte, si perde la variabilità di chi non è mai stato assunto, e la correlazione osservata risulta artificialmente più bassa di quella vera. La correzione serve a restituire la stima che si otterrebbe su un campione non filtrato. Sackett e colleghi sostengono che quella correzione, nella sua forma più diffusa, assumeva una restrizione più forte di quella reale — e quindi gonfiava i coefficienti più del dovuto, soprattutto per i test cognitivi. Tolta la sovracorrezione, i test di abilità cognitiva generale scendono a 0,31. I colloqui strutturati, meno esposti a quel tipo di distorsione perché più raramente usati come unico filtro di selezione, scendono meno: restano a 0,42.
La classifica, oggi
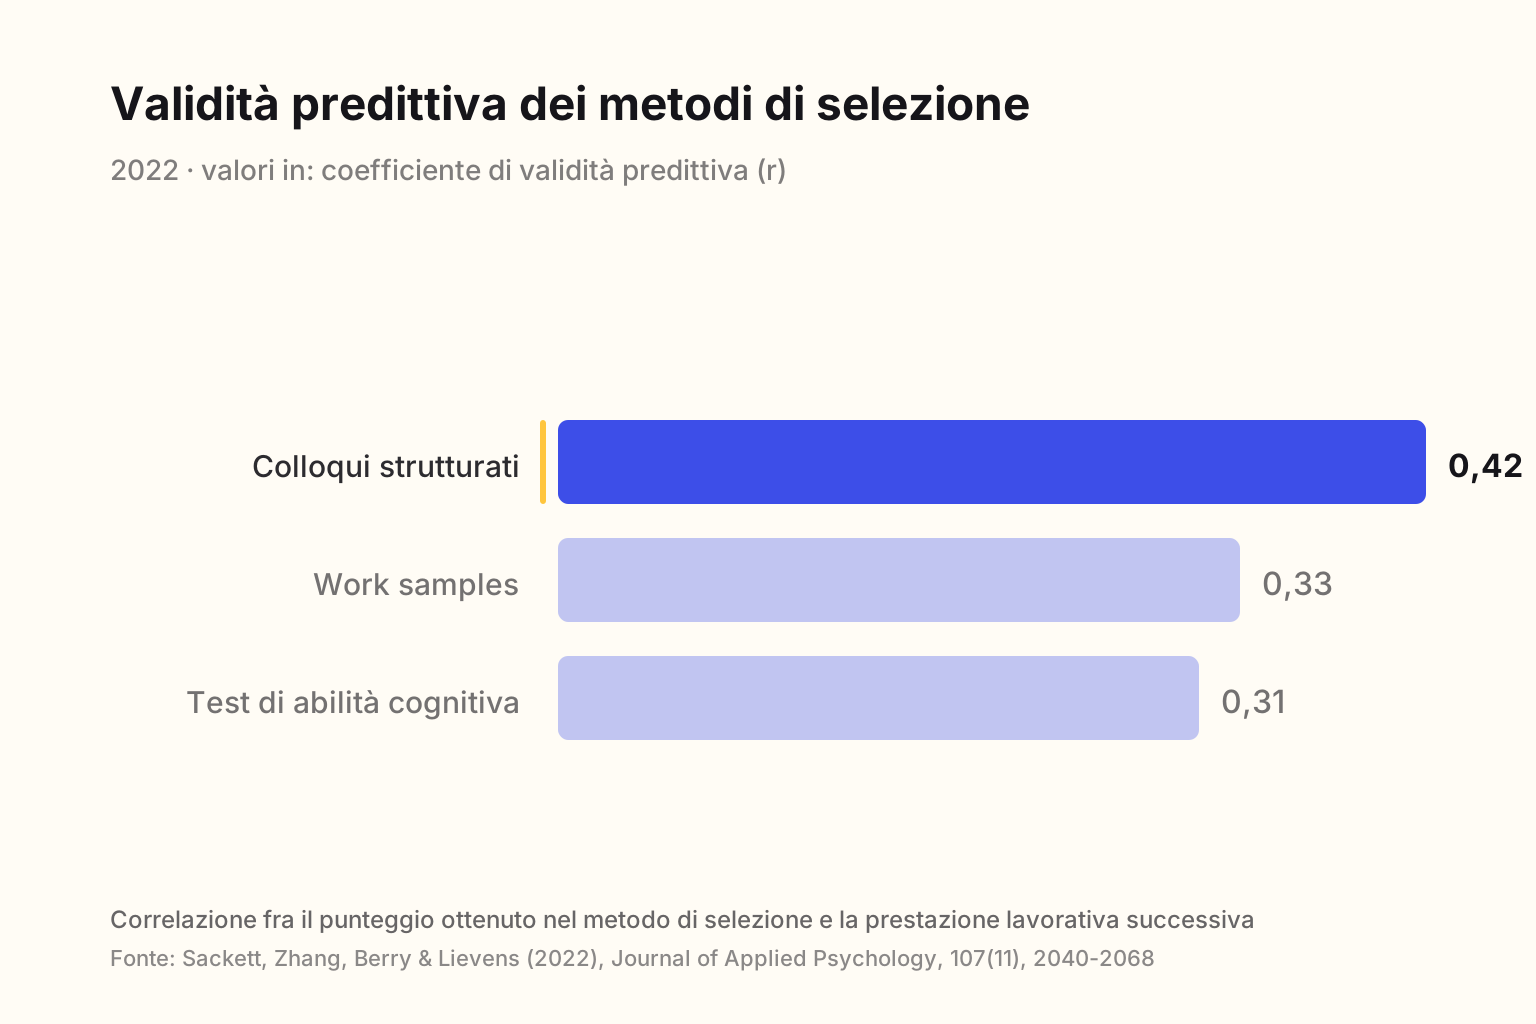
Il risultato pubblicato è una classifica tra i metodi di selezione esaminati nella meta-analisi: colloqui strutturati a 0,42, work sample test — le prove pratiche che simulano compiti reali del ruolo — a 0,33, test di abilità cognitiva generale a 0,31. Per la prima volta in una sintesi di questa portata, il metodo più "umano" della selezione batte quello più standardizzato, e questo capovolge un'intuizione che la letteratura HR ripeteva da decenni: più il test somiglia a un numero oggettivo, più prevede bene.
Chi contesta la correzione
La revisione non è passata senza repliche. Nel 2023 In-Sue Oh, Huy Le e Philip Roth hanno pubblicato una critica puntuale, sostenendo che la rimozione di quella correzione fosse ingiustificata: applicando lo schema originale di Schmidt e Hunter, colloqui strutturati e abilità cognitiva generale tornerebbero sostanzialmente equivalenti, intorno a 0,51. È un dibattito metodologico, non una nuova raccolta empirica: nessuno studio indipendente del 2023-2024 ha replicato la stima di Sackett con dati nuovi, nel senso di un campione fresco di assunzioni seguite nel tempo. Vale anche la pena dire con chiarezza che cosa manca: le fonti consultate non riportano il numero totale di studi primari né la dimensione campionaria aggregata usata da Sackett rispetto a Schmidt-Hunter 1998, informazione che servirebbe a valutare quanto sia solida la base empirica dietro al ribaltamento. Chi scrive software di selezione e cita "0,42" come fatto acquisito sta citando un numero contestato da chi ha pubblicato la critica più rigorosa a riguardo, non un consenso.
Colloquio clinico o colloquio strutturato: non è la stessa cosa
C'è un'ambiguità che vale la pena sciogliere subito, perché è quella su cui si gioca tutto. La tradizione di ricerca da cui vengo — quella di Meehl sulla contrapposizione fra giudizio clinico e giudizio statistico — ha passato settant'anni a mostrare che l'intuizione dell'esperto, lasciata libera di seguire il proprio istinto durante un colloquio non vincolato, prevede male la prestazione futura. Il colloquio che vince in questa meta-analisi non è quello. È il colloquio in cui le stesse domande vengono poste a tutti i candidati, nello stesso ordine, e le risposte vengono valutate con una griglia comportamentale concordata in anticipo — tipicamente domande comportamentali ("racconti un episodio in cui...") o situazionali ("che cosa farebbe se..."). La struttura, non l'intervistatore, è ciò che genera la validità: tolta la griglia e lasciato campo libero all'impressione, il colloquio torna a essere il giudizio clinico che la letteratura ha imparato a non fidarsi.
Che cosa significa davvero "strutturato"
Qui si apre il problema italiano. Chiunque abbia fatto selezione in questo paese sa che "colloquio strutturato" è un'etichetta che si applica a tutto: a una scheda di domande standard seguita alla lettera, e a una chiacchierata libera in cui il recruiter ha davanti un foglio che non consulta mai. La differenza fra le due cose, agli occhi di chi deve giustificare una decisione di assunzione, è enorme, ma raramente viene verificata. Un processo che chiama "strutturato" un colloquio senza griglia di valutazione condivisa, senza domande fissate in anticipo e senza più di un valutatore indipendente non sta usando lo strumento che ha prodotto 0,42: sta usando il nome dello strumento, che è una cosa diversa.
Una correlazione non è un verdetto
Vale la pena fare i conti fino in fondo, perché anche il miglior numero della classifica resta un numero modesto. Un coefficiente di 0,42, elevato al quadrato, spiega circa il 18% della varianza nella prestazione lavorativa successiva. Significa che su cento punti di differenza fra le prestazioni future dei candidati, il colloquio strutturato — il migliore degli strumenti esaminati — ne intercetta meno di un quinto. Il resto è determinato da fattori che il colloquio, per quanto ben costruito, non può vedere: il contesto di lavoro, il team in cui la persona finirà, eventi personali, e il modo stesso in cui viene definita e misurata la "prestazione" che si vuole predire — di solito la valutazione di un supervisore, che porta con sé tutto il rumore delle valutazioni umane di cui si occupa gran parte di questa materia. Dire che un metodo "funziona meglio degli altri" non equivale a dire che funziona bene in assoluto: equivale a dire che sbaglia un po' meno degli altri, il che è un'informazione utile solo se non la si scambia per una garanzia.
Chi in azienda sta per aggiornare il proprio processo di selezione citando questo nuovo ranking ha davanti una domanda più utile del numero stesso: se chiedessimo, oggi, a chi fa i nostri colloqui di mostrarci la griglia di valutazione che usa — quella scritta prima, non quella che ricostruisce dopo — ne troveremmo una?
7 fonti, verificate prima di pubblicare
Apri l'elenco
- https://www.ovid.com/journals/japsy/abstract/10.1037/apl0000994~revisiting-meta-analytic-estimates-of-validity-in-personnel?redirectionsource=fulltextview
- https://www.cogn-iq.org/references/cqr-sfmpwxpn8p/
- https://intrvio.com/blog/structured-interview-predictive-validity
- https://www.noon.ai/blog/articles/356-structured-interview-validity
- https://100hires.com/structured-interviews.html
- https://voicit.com/en/blog/human-resources/structured-interview/10733/
- https://www.cambridge.org/core/services/aop-cambridge-core/content/view/A20984B138319E3D432E643978BF026D/S175494262300024Xa.pdf/revisiting_the_design_of_selection_systems_in_light_of_new_findings_regarding_the_validity_of_widely_used_predictors.pdf
Ogni affermazione empirica di questo pezzo è ancorata a una fonte verificata durante la scrittura. Se ne trovi una che non regge, segnalacela: la correzione è parte del metodo.